Exercice 3 - Partie A · Bac Numérique et Sciences Informatiques Amérique du Nord 2024 (jour 1)
Thème : Modularité, API et paradigmes de programmation · Tiré du sujet Jour 1 (2024)
Énoncé
EXERCICE 3 (8 points)
Cet exercice porte sur la programmation Python, la modularité, les bases de données relationnelles et les requêtes SQL.
Une flashcard, autrement appelée carte de mémorisation, est une carte papier sur laquelle se trouve au recto une question et au verso la réponse à cette question. On les utilise en lisant la question du recto puis en vérifiant notre réponse à celle du verso. Une étudiante souhaite réaliser des flashcards numériquement.
Partie A
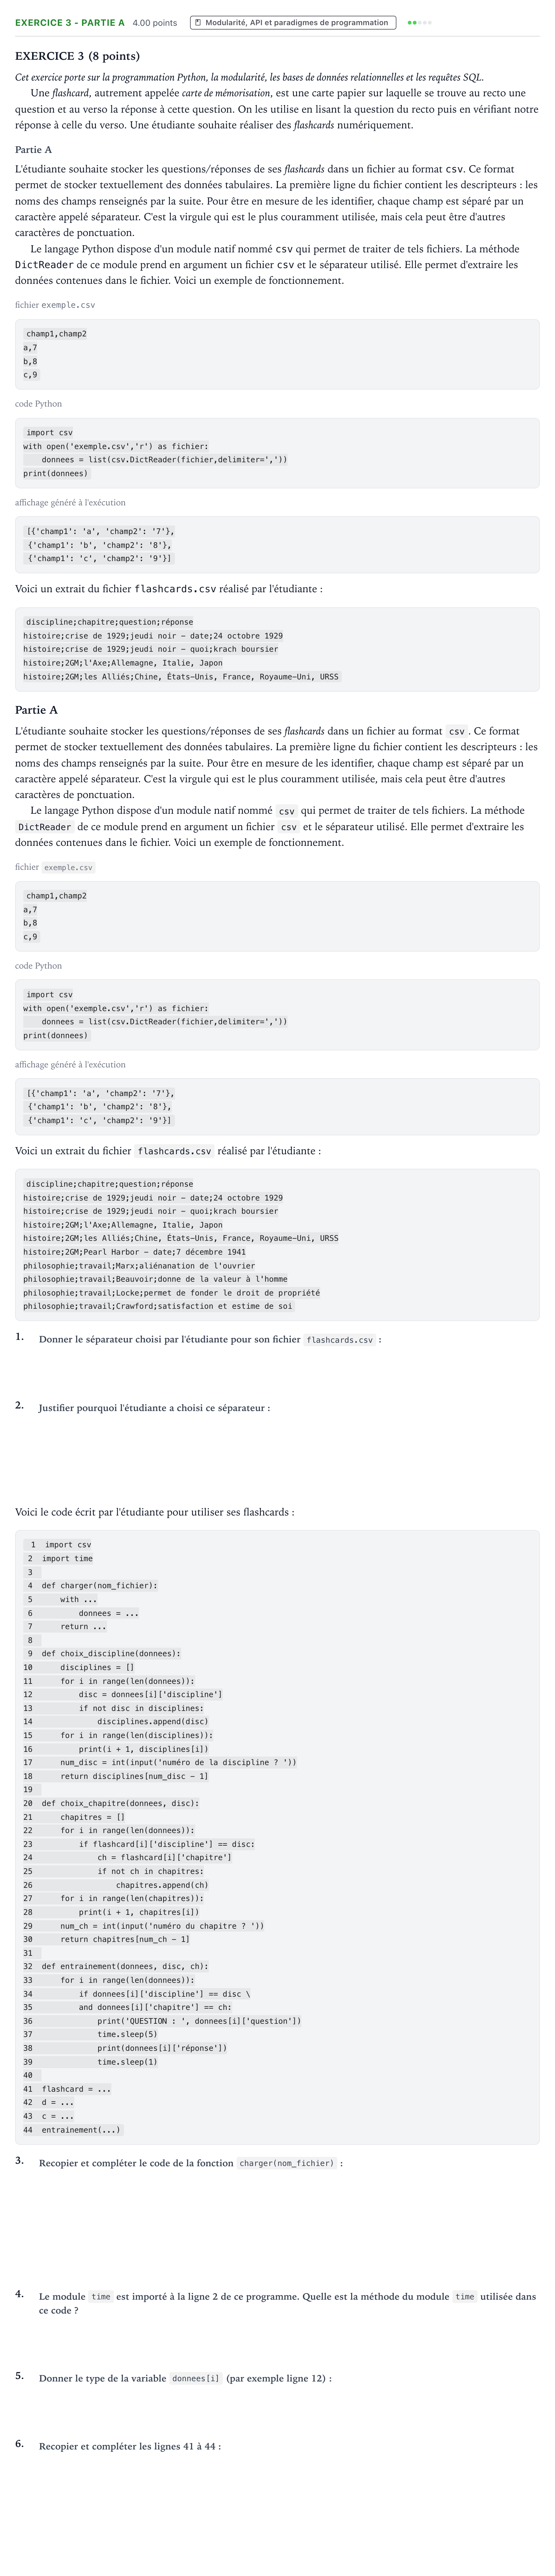
L'étudiante souhaite stocker les questions/réponses de ses flashcards dans un fichier au format csv. Ce format permet de stocker textuellement des données tabulaires. La première ligne du fichier contient les descripteurs: les noms des champs renseignés par la suite. Pour être en mesure de les identifier, chaque champ est séparé par un caractère appelé séparateur. C'est la virgule qui est le plus couramment utilisée, mais cela peut être d'autres caractères de ponctuation.
Le langage Python dispose d'un module natif nommé csv qui permet de traiter de tels fichiers. La méthode DictReader de ce module prend en argument un fichier csv et le séparateur utilisé. Elle permet d'extraire les données contenues dans le fichier. Voici un exemple de fonctionnement.
fichier exemple.csv
champ1,champ2
a,7
b,8
c,9 code Python
import csv
with open('exemple.csv','r') as fichier:
donnees = list(csv.DictReader(fichier,delimiter=','))
print(donnees) affichage généré à l'exécution
[{'champ1': 'a', 'champ2': '7'},
{'champ1': 'b', 'champ2': '8'},
{'champ1': 'c', 'champ2': '9'}] Voici un extrait du fichier flashcards.csv réalisé par l'étudiante:
discipline;chapitre;question;réponse
histoire;crise de 1929;jeudi noir - date;24 octobre 1929
histoire;crise de 1929;jeudi noir - quoi;krach boursier
histoire;2GM;l'Axe;Allemagne, Italie, Japon
histoire;2GM;les Alliés;Chine, États-Unis, France, Royaume-Uni, URSS
histoire;2GM;Pearl Harbor - date;7 décembre 1941
philosophie;travail;Marx;aliénanation de l'ouvrier
philosophie;travail;Beauvoir;donne de la valeur à l'homme
philosophie;travail;Locke;permet de fonder le droit de propriété
philosophie;travail;Crawford;satisfaction et estime de soi 1.
2.
Voici le code écrit par l'étudiante pour utiliser ses flashcards:
1 import csv
2 import time
3
4 def charger(nom_fichier):
5 with...
6 donnees =...
7 return...
8
9 def choix_discipline(donnees):
10 disciplines = []
11 for i in range(len(donnees)):
12 disc = donnees[i]['discipline']
13 if not disc in disciplines:
14 disciplines.append(disc)
15 for i in range(len(disciplines)):
16 print(i + 1, disciplines[i])
17 num_disc = int(input('numéro de la discipline ? '))
18 return disciplines[num_disc - 1]
19
20 def choix_chapitre(donnees, disc):
21 chapitres = []
22 for i in range(len(donnees)):
23 if flashcard[i]['discipline'] == disc:
24 ch = flashcard[i]['chapitre']
25 if not ch in chapitres:
26 chapitres.append(ch)
27 for i in range(len(chapitres)):
28 print(i + 1, chapitres[i])
29 num_ch = int(input('numéro du chapitre ? '))
30 return chapitres[num_ch - 1]
31
32 def entrainement(donnees, disc, ch):
33 for i in range(len(donnees)):
34 if donnees[i]['discipline'] == disc \
35 and donnees[i]['chapitre'] == ch:
36 print('QUESTION: ', donnees[i]['question'])
37 time.sleep(5)
38 print(donnees[i]['réponse'])
39 time.sleep(1)
40
41 flashcard =...
42 d =...
43 c =...
44 entrainement(...) 3.
4.
5.
6.
Corrigé
Corrigé proposé par AprenAI (non officiel)
1. Donner le séparateur choisi par l'étudiante pour son fichier flashcards.csv.
Réponse : ; / point-virgule
2. Justifier pourquoi l'étudiante a choisi ce séparateur.
Réponse : Certaines réponses contiennent des virgules (ex. "Allemagne, Italie, Japon"). Si la virgule était le séparateur, ces champs seraient découpés à tort en plusieurs colonnes.
3. Recopier et compléter le code de la fonction charger(nom_fichier) qui lit le fichier dont le nom est fourni en argument et qui renvoie les données lues sous la forme d'un dictionnaire comme dans l'exemple fourni précédemment.
Réponse : ```python def charger(nom_fichier): with open(nom_fichier, 'r') as fichier: donnees = list(csv.DictReader(fichier, delimiter=';')) return donnees ```
Les réponses des 3 questions restantes et l’explication pas à pas sont réservées aux membres Premium. Premium
Résous-le ici : correction automatique, indices et corrigé détaillé.